0. background
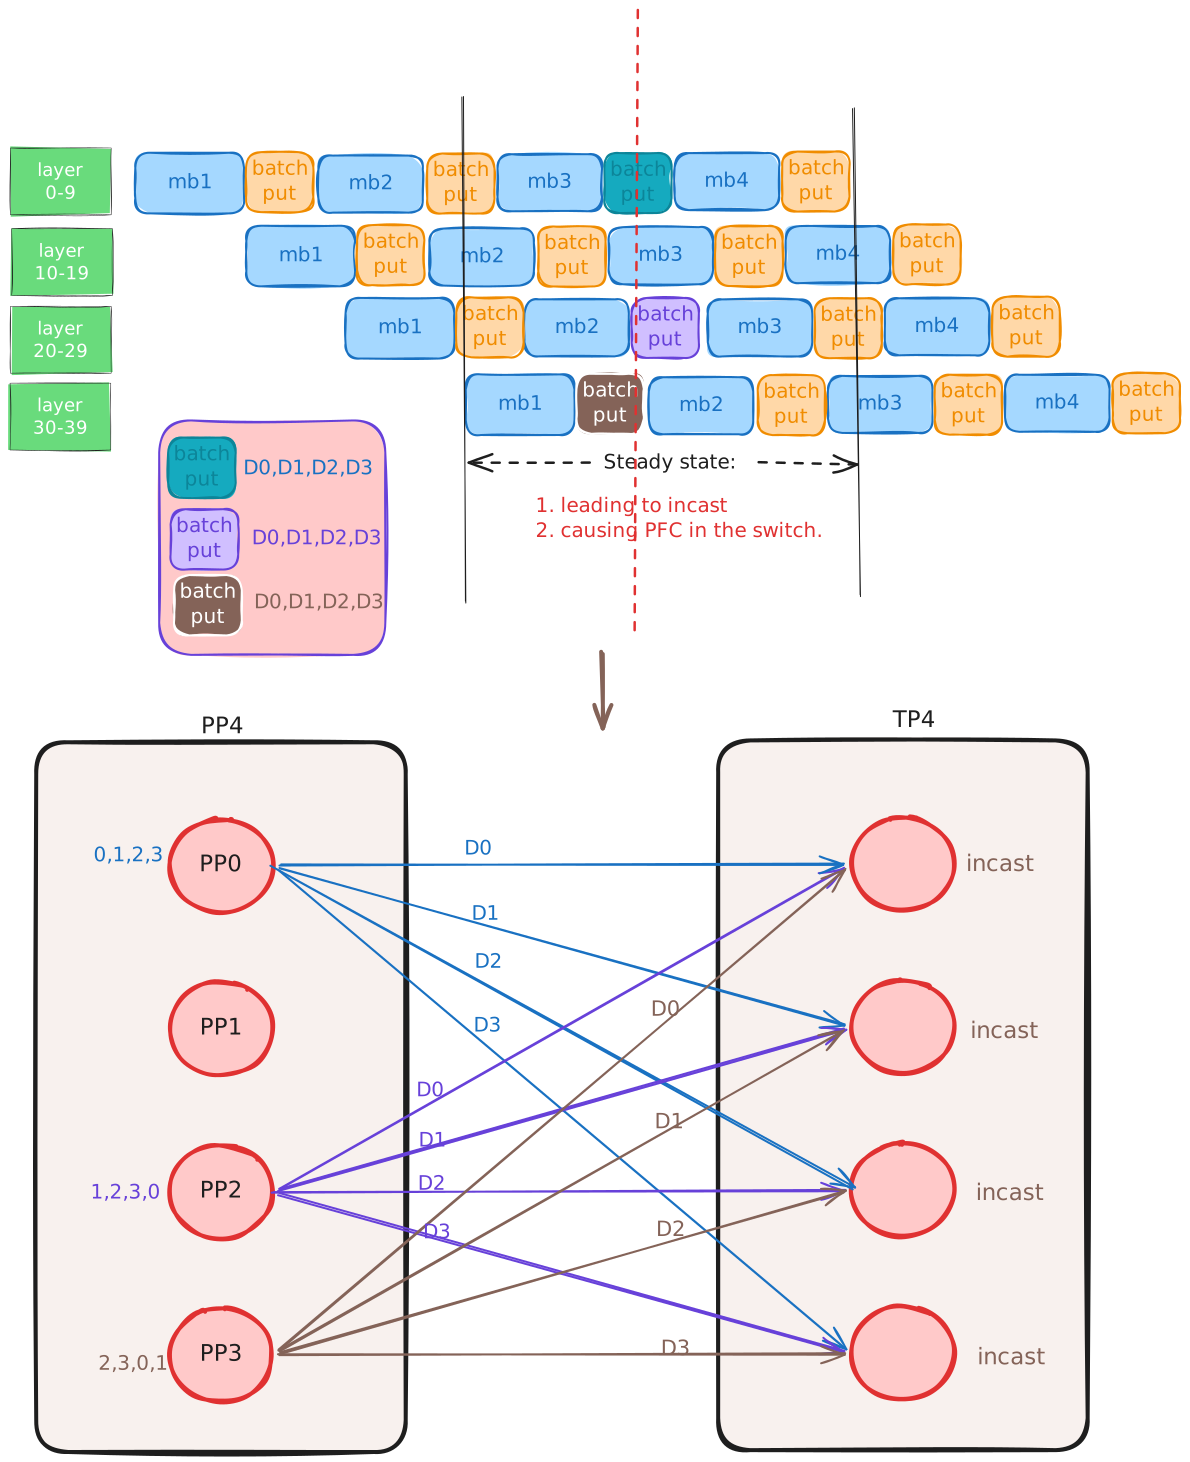
当前主流模型部署时存在 prefill 侧开 pp/cp,当 pipe 流水稳定时就会频繁出现 incast,在交换机侧会观察到 pfc (Priority-based Flow Control, PFC),如下方黑色线内的红色虚线时刻。
当前 sglang/vllm 内的实现,如下方图所示,此时就会出现 decode 侧 tp rank 0 拥塞,因为同时被 prefill 的 pp0,pp2,pp3的流量打满。
此时,最 naive 的方案就是,直接给pp0,pp2,pp3此时的每个人要发 kv cache 前进行编排,每一轮一发,下一轮 offset 加一,例如:第一轮每个人同轨先发。但是发现没法保证的就是每个 gpu 的进度都是如此完美,故依旧会出现 incast。
综上,还有两张方案。
1. methods
增加 nvlink 的拷贝,让所有的流量变成同轨,因为 nvlink 够快,把转发藏在 rdma 的时间里。
不论最后是采取哪个方案,在 gpu 自己的视角看,任务只包括三类:
- 我发 cache 给同轨的 decode tp rank i,或收同轨的 prefill rank i(RDMA)
- 我要等代理发过来的流量 (nvlink)
- 我要让别人代理的流量(nvlink)
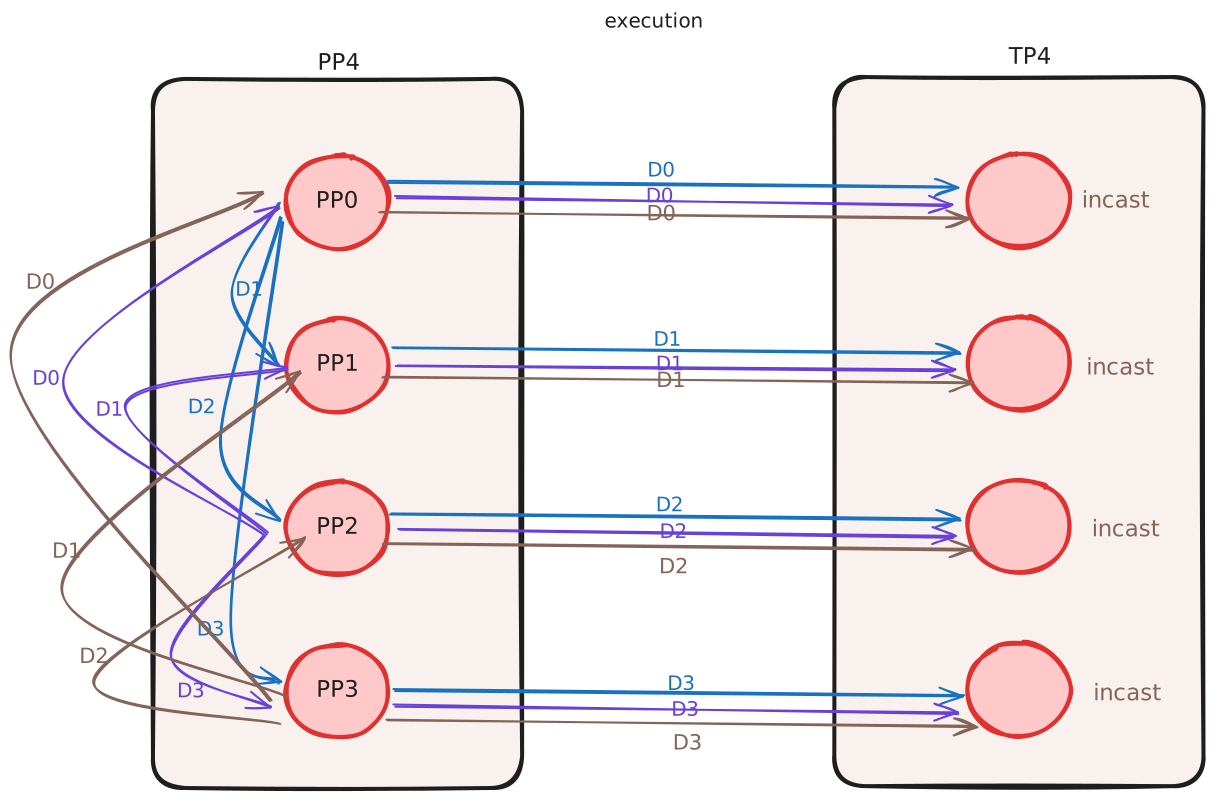
send-side pxn(stay)
优势:可以让发送端所有网卡带宽吃满。 缺点:从decode 视角看,接收 c我ache 的上限就是网卡带宽总和。
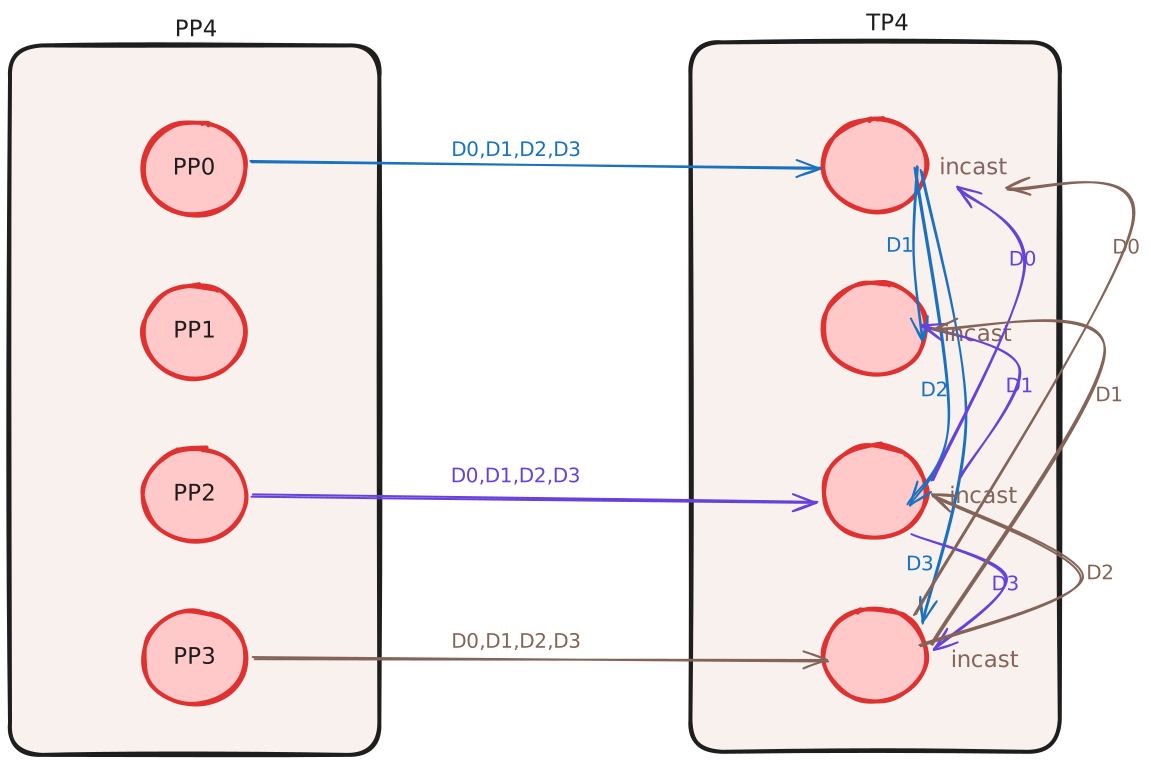
receive-side pxn(pass)
优势:decode 侧 peak bw 是 nic + ce copy 缺点:无法用满所有 nic 的 bw,并且 decode 的显存更加重要
2. Design
-
sender relay receiver 三者的控制信号怎么处理? a. sender 一直在 desc 的 ring buffer 内填写每个 batch_trasfer_sync 的要代理的任务 [cpu] b. sender 在 stream 上 cuda memcpy 结束的时候 cuStreamWriteValue64到doorbell signal内,确保 rmda 不会搬错数据[gpu] c. relay 去 poll doorbell,并更新 completed。[cpu] d. sender 等待 completed
-
消费队列怎么设计?
- 每个 rank 自己持有 7 个 lane,合计 1GB,简称为 relay buffer。负责转发不同机内rank的代理流量。
- 每个 lane 内有 18 个 8MB(128 个 64KB) 的槽,每个 lane 内由 credit/head/completed 来维护,以 ring 的方式不停生产和消费。
-
engine怎么处理三类任务? 在 prefill 的 node 内,每个 rank 都有自己的 sglang/vllm process,每个 preocess 内会有多个线程调用 transfer_data。所以在 engine 需要有三类角色: A 负责把跨轨的任务持续发到 relay B 写入 lane0-7 中已经好了的任务到 slice_queue C 只负责搬 slice_queue
-
图内没有画的细节
shm 让多个进程共享内存,用 shm_open() 创建/打开共享内存对象,ftruncate() 设置大小,然后各进程用 mmap(..., MAP_SHARED, ...) 映射同一块内存,最后用 shm_unlink() 删除名字。且有多个进程写,这些需要有一套完整机制。
relaybuffer 会有两个 gpu 写和读,这里需要让这块内存到处 ipc,支持跨进程访问。这也需要有一套不会互相覆盖并且高效的流水。
MPSC 队列需要考虑好锁的使用,不然多线程可能导致数据写错。
copy engine 和 rdma 的传输要严格并行处理,确保cudaMemcpybatch 会藏在 rdma 内。
所有资源用RAII模式
pipeline 流水优化
cudaMemcpy 3us
NCCL
1. 资源不同
nccl PXN :
- sender 下 kernel 把 src address 数据搬到 relay rank 的 fifo buffer
- relay rank 的 cpu proxy 下 ncclNet→isend() 走 RNIC 传输
- receiver rank 的 cpu proxy 下 ncclNet→irecv() 走 RNIC 传输
- receiver 下 kernel 把数据搬到目标 dst address
2. 注册与同轨冲突
NCCL PXN 与“网络 user-buffer direct registration”幸福二选一。PXN 的网络发送方是 relay rank,而数据注册必须是 sender rank。它要判断 zerocopy 还是 PXN。。。
3. 双边协议的妥协
sender/receiver 必须下一对匹配的 isend/irecv,又因为每次 recv 的时候只能是连续的地址,vllm 的 nccl connector 尝试过在接收侧 empty 一个连续的 tensor 把 prefill 的 kv cache 传过来后再 scatter分发来提高传输性能,但是总体来说 PD 分离场景都是完全不可接受的。
- decode 侧 empty 一块内存,直接影响到 decode 能 batch 的请求数量,且实测过程中,decode 侧 empty 多少都会存在被 prefilll 打爆的情况,导致整个 pd 系统完全不可高负载运行。(我早期提过修复 nccl connector 的 pr,后来其他人包括我跟 vllm 的工程师讨论后,vllm 官方直接删除 nccl connector 传输 kv cache 的所有代码。https://github.com/vllm-project/vllm/issues/33115 )
- sender 和 receiver 都需要下 kernel 来搬数据到目标地址,直接影响 prefill 侧下一组请求的计算/decode 当前组的计算
- nccl 的网络传输在推理高并发场景存在丢失请求。(前段时间和 nccl 工程师讨论后在新版 nccl 内修复了这个bug。https://github.com/NVIDIA/nccl/issues/2119